
第三層寫到這裡六篇了。第 5 篇把檔案給它看,第 6 篇講窗口裡該放什麼,第 7 篇拆開檢索,第 8 篇量它準不準,上一篇問了「那整份塞進去行不行」。
零件都在了,但有一件事從頭到尾沒做過:把它們擺進同一個請求裡。 而你跟一個代理講話,講的其實就是這一包東西。
「我知道要切塊、要重排序、要標出處了,那這些東西到底照什麼順序放?」
說穿了,一個請求裡只有四種東西,而它們的順序不是風格問題。今天先把它們組起來,再把這一層的帳結掉。
這個實驗不用寫程式,打開你現在在用的那個提示詞就好。
第一步:把它拆成兩疊。每次都一樣的放一疊(角色設定、格式要求、範例、工具定義),每次都不一樣的放另一疊(使用者的問題、這次撈回來的資料、今天的日期)。
第二步:看這兩疊現在在你的請求裡是怎麼排的。有沒有「每次都不一樣」的東西,混在「每次都一樣」的前面?
最常見的那一個是日期。很多人會在系統提示開頭寫一句「今天是 2026 年 9 月 24 日」,然後整段前綴每一輪都不一樣。
如果你有,你剛剛找到的就是這一篇要修的第一個東西。
不管你的系統長多複雜,送出去的那一包東西可以分成四類:
| 這一疊是什麼 | 多久變一次 | 它是哪一篇的產物 |
|---|---|---|
| 系統提示、工具定義 | 幾乎不變 | 第 4 篇的自訂指令 |
| 範例(少樣本) | 幾乎不變 | 第 3 篇的情境學習 |
| 檢索回來的那幾塊 | 每一次都不一樣 | 第 7 篇切出來、第 8 篇排過序的 |
| 使用者的問題 | 每一次都不一樣 | 對方打的字 |
上面兩排是資產,第 4 篇講過它們會變成你維護的東西;下面兩排是流量,每一次呼叫都不同。
而正確的順序,就是這張表的順序:資產在前,流量在後。 這不是美感,是三件事各自壓出來的結論。
想通這件事,兩個看起來不相關的建議就變成同一條了:第 4 篇說「穩定的放前面才有前綴可以快取」,第 6 篇說「窗口是訊噪比問題」。一個在省錢,一個在保品質,但它們要你做的動作一模一樣。
第一,快取邊界。 第 4 篇講過快取的前綴依 tools → system → messages 建立,動了哪一層,那一層和後面全部失效。官方文件的建議寫得很直白(2026-09-24 查):把靜態的內容(工具定義、系統指令、脈絡、範例)放在提示詞的開頭,再用 cache_control 標出可重複使用的那一段結束在哪裡。
把日期戳放進系統提示,違反的就是這一條:前綴每一輪都是新的,快取永遠不會命中,而且它不會報錯。官方文件對「沒達到門檻」的描述也是同一個調性:低於最小長度的請求會被當成沒有快取直接處理,不回傳任何錯誤,你只能從回應的 usage 看出來,cache_creation_input_tokens 與 cache_read_input_tokens 兩個都是 0 就是沒中。
這一段要謝謝讀者 helenanova 在第 4 篇留言補的實務經驗,他把這個坑講得更細:把日期或 session 狀態塞進系統提示,「每一輪前綴都在變,快取永遠不命中,還以為快取沒開」。他給的兩個習慣也一起收進來:時間戳這種每輪必變的東西放在
messages最尾端,以及改完提示詞先送一次count_tokens確認還在門檻之上,因為刪字刪太多跌破門檻,快取一樣是悄悄不生效。
第二,訊噪比與位置。 第 6 篇說窗口是訊噪比的問題不是容量問題,上一篇補上位置這一項:重要的東西放頭尾,中間最吃虧。這兩件事合起來給的指示很具體:檢索回來的那幾塊要少而準,而且不要被埋在一堆固定文字的中間。 排在資產之後、問題之前,正好是「靠近結尾」的位置。
第三,出處的粒度。 第 8 篇講過引用的粒度就是切塊的粒度:想讓它引用得到你那幾塊,就要把每一塊放成一份 document,而不是全部黏成一段文字塞進去。所以這幾塊不只是「放在後面」,還要以區塊的形式放。順帶一提,第 5 篇提過官方建議 PDF 放在文字前面,那是同一條規則的舊版本:穩定的在前,易變的在後,而問題永遠在最後。
這個坑每一步都不會報錯:
cache_control,沒有警告。usage,cache_creation_input_tokens 跟 cache_read_input_tokens 兩個都是 0。整條鏈上唯一會說話的地方,是 usage 裡那兩個數字。 這跟第 8 篇那句「沒有人會告訴你檢索失敗了」是同一種病:功能沒有壞,它只是沒有生效。
把上面三件事寫成結構,大概是這個樣子:
tools          工具定義                 幾乎不變
system         角色、格式要求、規則       幾乎不變
               範例                     幾乎不變
               ← cache_control 斷點放這裡
messages       document 區塊:第 1 塊     每次都不一樣
               document 區塊:第 2 塊
               document 區塊:第 3 塊
               text:使用者的問題         每次都不一樣
               text:今天是 2026-09-24    每次都不一樣,所以放最後
三個容易放錯的地方:
document 區塊,這樣引用才指得回哪一塊,第 8 篇那個「答案指得回原文」才成立。這張圖就是第三層六篇的成品。 你不會在任何一份官方文件裡看到它,因為每一條規則分別寫在不同的頁面上。
還有兩句要自己打折。第一,這是一個起點,不是唯一解:有些系統會把問題也放到比較前面,因為他們要讓模型先知道任務再讀資料,那是另一組取捨,值得自己量。第二,斷點不是越多越好:第 4 篇提過自己指定最多四個,而每一個斷點都在賭「這一段之後真的不會變」。賭錯了,那一段的快取就白寫。
第三層給了你一個很大的能力:它終於知道你的事了。 現在把帳單攤開。
| 你多了什麼 | 誰在維護 | 它什麼時候會咬你 |
|---|---|---|
| 一個向量模型(第 7 篇) | 另一家公司 | 它換版本或退役的時候,整個索引要重算 |
| 一組切塊參數(第 7 篇) | 你 | 換向量模型、換語料,最佳值就跟著變 |
| 一個知識庫(第 5 篇) | 你或你的團隊 | 沒人下架舊文件的時候,它會用很篤定的語氣引用過期的那一份 |
| 一組評估配對(第 8 篇) | 你 | 文件改版之後,題目的答案會悄悄變錯 |
| 一個排好順序的請求(這一篇) | 你 | 有人在系統提示裡加一行「今天是幾號」的時候 |
這五樣沒有一樣是一次性的。 這才是第三層真正的代價:它不是一筆安裝費,是一份持續的維護合約。
而檢驗它有沒有壞掉,要用兩把尺一起量。 第 4 篇那十題量的是「它答對沒有」,第 8 篇那組配對量的是「它有沒有拿到對的那一段」。只看前面那把,你會把運氣當成實力;只看後面那把,你會把撈得很準卻答得很爛的系統當成成功。
你剛剛排好的那個請求,下一輪要從頭再排一次。系統提示是你每次貼的,範例是你每次附的,檢索回來的那幾塊是每次現撈的,連使用者前面說過的話,都要原封不動再送一遍。
第 5 篇講過,權重是凍結的,會變的只有這一次推論的輸入。所以這條管線上沒有任何一個地方,記得上一輪發生過什麼。
所以這裡要把兩個很常被混在一起的東西分乾淨。先看它們在一個代理裡各自站在哪:
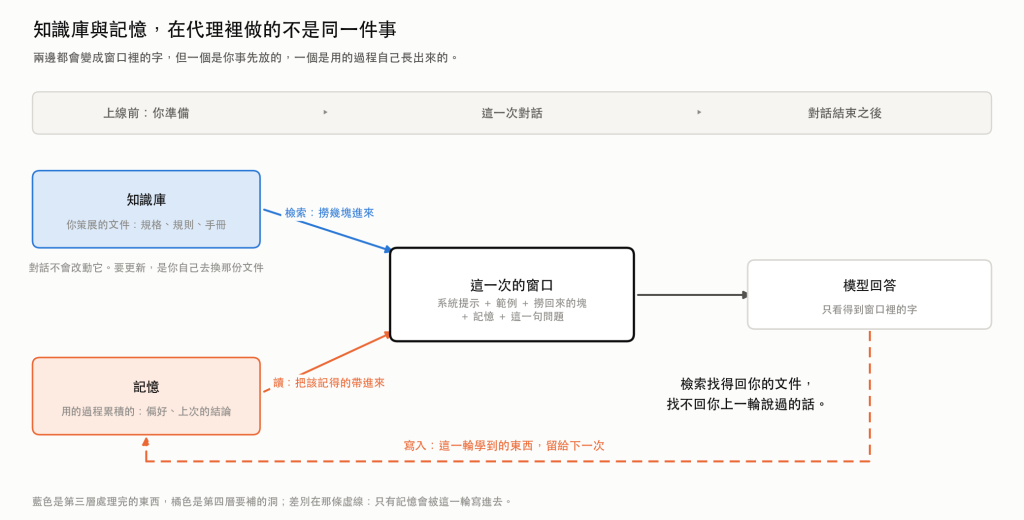
差別全在那條虛線。 知識庫是你上線前放進去的,對話不會改動它;記憶則是這一輪讀出來、也被這一輪寫入的,所以它自己會長大。那個「寫入」就是下一層整層在處理的動作。攤成表格更清楚:
| 面向 | 知識庫 | 記憶 |
|---|---|---|
| 東西從哪來 | 你事先放進去的文件 | 每一輪寫入、累積下來的 |
| 內容是什麼 | 事實、規格、規則 | 發生過的事、你的偏好、上次的結論 |
| 誰決定它存在 | 你策展 | 它自己長出來 |
| 壞掉的樣子 | 引用了過期的文件 | 記住了一句你早就改口的話 |
檢索找得回你的文件,找不回你上一輪說過的話。 那是另一個洞,補它的方法也不一樣。
而在補之前,先看帳單:那段對話歷史每一輪都要重送,而且只會越來越長。這一層結束了,下一層從那張帳單開始。
多了什麼能力:你有一個排得出理由的請求。哪一段放前面、斷點放哪裡、那幾塊要不要各自成塊,每一個決定背後都有一條規則,而不是「大家都這樣寫」。
多付了什麼代價:一份維護合約。向量模型、切塊參數、知識庫、評估配對、請求順序,五樣東西都會隨著時間鬆掉,而它們鬆掉的時候都不會報錯。
它不記得你上一輪說過什麼,而你每一輪都在重送。
這一層補的是「它不知道你的事」。下一層要補的是另一個洞:跨輪、跨對話留下來的東西。而第一件要算清楚的,是那段每一輪都重送的對話歷史到底要花多少錢。
document 區塊。count_tokens(Claude 官方文件):改完提示詞先量一次,確認自己還在快取門檻之上。

把這一層的帳結得很乾淨,也謝謝採用那個例子。順手補一個搭配的做法:既然整條鏈唯一會說話的是 usage 裡那兩個數字,就把 cache_read_input_tokens 當成指標收下來——每次改提示詞或發版後看一眼命中率有沒有掉,比等帳單才發現快取沒中快得多。「功能沒有壞,只是沒有生效」這類問題,最後都得靠這種自己埋的觀測點才抓得到。


 iThome鐵人賽
 看影片追技術